# Robots.txt Dosyası Nedir? Nasıl Kullanılır? (Kural Örnekleri)
Çok fazla sayfası olan bir web sitesinde ya da geniş envanterli e-ticaret sitelerinde, yüksek kâr getiren ürün sayfalarının **arama motorları tarafından dizine eklenmemesi genellikle bir tarama bütçesi (crawl budget) sorunudur**. Kapsamlı navigasyon, dinamik fiyat filtreleri ve parametreli URL’ler, arama motoru botlarını sonsuz döngülere sokarak sitenin tarama limitlerini hızla tüketebilmektedir. Bu sorunu çözmenin en net yolu, **kök dizinde yer alan robots.txt dosyasını doğru bir şekilde yapılandırmaktır**. Arama motoru botlarına hangi dizinlerin taranıp hangilerinin yok sayılacağını kesin kurallarla bildiren bu dosya, Googlebot’un kısıtlı tarama bütçesini değersiz filtre sayfaları yerine doğrudan stratejik ürünlere harcamasını sağlar. Doğru kurgulanmış bir robots.txt dosyası sunucu yükünü düşürür ve yeni ürün sayfalarının indekslenme hızını artırarak sitenin organik görünürlüğünü iyileştirmenize olanak sağlar.
Bu içeriğimizde, **robots.txt dosyasının ne olduğunu, ne işe yaradığını ve nasıl oluşturulduğunu ayrıntılı kural listesi** ile birlikte sizlere sunuyoruz. Keyifli okumalar!
## Robots.txt Dosyası Nedir?
**Robots.txt dosyası**, web sitenizin kök dizininde (root directory) barındırılan ve arama motoru botlarına (Googlebot, Bingbot vb.) sitenizin hangi bölümlerini tarayabileceklerini veya tarayamayacaklarını bildiren düz bir metin dosyasıdır.
## Robots.txt Dosyası Ne İşe Yarar?
Bir arama motoru botu (Googlebot, Bingbot vb.) sitenizi ziyaret ettiğinde, ilk olarak **orneksiteadresi.com/robots.txt** adresine gider. Buradaki talimatları okur ve tarama rotasını bu kurallara göre çizer. Bu dosya bir güvenlik duvarı veya şifreleme yöntemi değildir; yalnızca botlara yol gösteren bir güvenlik görevlisidir. Halka açık bir dosya olduğu için tarayıcı çubuğuna yazan herkes tarafından görüntülenebilir.
Robots.txt dosyasının temel işlevi, **arama motoru botlarının web sitenizdeki tarama trafiğini (crawl traffic) yönetmektir**. Özellikle binlerce sayfanın bulunduğu geniş çaplı sitelerde, botların gereksiz sayfalarla vakit kaybetmesini engeller.
Bu dosya sayesinde arama sonuçlarında görünmesini istemediğiniz **admin paneli girişleri, sepet sayfaları veya müşteri hesap detayları** gibi alanları botlara kapatabilirsiniz. Böylece sunucu kaynaklarınızı korur ve botların yalnızca **indeksleme stratejisi açısından değerli olan sayfalara** odaklanmasını sağlarsınız.
Ayrıca site haritasının (XML Sitemap) konumunu belirterek, botların sitenizin güncel haritasına en kısa yoldan ulaşmasını gerçekleştirir.
## Robots.txt Dosyası Nasıl Oluşturulur?
Arama motoru botlarının sitenizi nasıl tarayacağını belirleyen **robots.txt dosyası**, katı teknik standartlara tabidir. [En iyi ve modern e-ticaret altyapıları](https://ikas.com/tr/blog/en-iyi-e-ticaret-altyapilari) **(örneğin ikas)** kullanılarak oluşturulan e-ticaret sitelerinde bu dosya genellikle arama motoru standartlarına uygun olarak otomatik oluşturulur; ancak manuel bir kurulum veya özel bir sunucu yapılandırması yapıyorsanız şu kurallara uymanız şarttır:
- **İsimlendirme ve Tekillik:** Dosyanın adı tamamen küçük harflerle **robots.txt** şeklinde olmalıdır. Bir web sitesinde (aynı ana makinede) yalnızca tek bir robots.txt dosyası barındırılabilir.
- **Kök Dizin Zorunluluğu:** Dosya mutlaka sitenin kök dizinine (root) yerleştirilmelidir. Örneğin; **https://orneksiteadresi.com/robots.txt** geçerli bir konumken, **https://orneksiteadresi.com/pages/robots.txt** gibi alt dizin kullanımları arama motorları tarafından doğrudan yok sayılır.
- **Kapsam ve Protokol Sınırları:** Bir robots.txt dosyası yalnızca bulunduğu protokole (http/https), ana makineye (host) ve bağlantı noktasına (port) hizmet eder. Yani **https://orneksiteadresi.com/robots.txt** içindeki komutlar, https://giris.orneksiteadresi.com (alt alan adı) veya http://orneksiteadresi.com (farklı protokol) için geçerli değildir. Alt alan adları veya standart dışı portlar (örneğin, **https://orneksiteadresi.com:8181**) için ilgili dizinlerde ayrı robots.txt dosyaları yayınlanmalıdır.
- **Karakter Kodlaması (UTF-8):** Dosya kesinlikle **UTF-8 formatında (ASCII dahil) kodlanmış** bir metin dosyası olmalıdır. Google botları, **UTF-8 aralığı dışındaki karakterleri okuyamaz**; bu durum dosyadaki tarama kurallarının tamamen geçersiz sayılmasına ve kritik dizinleme hatalarına yol açar.
> **📌 Eğer ikas gibi modern bir altyapı kullanıyorsanız, e-ticaret sitenizin robots.txt dosyası sistem tarafından SEO standartlarına uygun şekilde otomatik olarak oluşturulur. İhtiyaç duyduğunuzda bu kuralları arayüz üzerinden kolayca güncelleyebilir, global pazarlara satış yaparken farklı dil kırılımları için özel tarama kuralları belirleyebilirsiniz.**
## Robots.txt Dosyası Oluştururken Dikkat Edilmesi Gerekenler Nelerdir?
Robots.txt dosyasında doğru kuralları tanımlamak kadar, dosyanın doğru konumlandırılması ve arama motorları tarafından sorunsuz şekilde okunabilmesi de önemlidir. Dosyanızı oluştururken veya düzenlerken aşağıdaki teknik detaylara dikkat etmelisiniz:
- **Robots.txt dosyası erişim güvenliği sağlamaz:** Yönetim paneli gibi hassas alanları korumak için yalnızca Disallow kullanmak yeterli değildir. Kimlik doğrulama ve erişim kontrolleri uygulanmalıdır.
- **Robots.txt dosyası ana dizinde bulunmalıdır:** Örneğin **https://siteadresiniz.com/robots.txt** adresinde erişilebilir olmalıdır.
- **Sitemap bildirimi yapılabilir:** **Sitemap: https://siteadresiniz.com/sitemap.xml** satırı eklenerek XML site haritasının adresi arama motorlarına bildirilebilir.
- **Joker karakterler kullanılabilir:** Google, URL yollarında **\* (sıfır veya daha fazla karakterle eşleşme) ve $ (URL sonunu belirtme)** işaretlerini destekler.
📌 **Önemli not:** Robots.txt direktifleri tüm botlar tarafından aynı şekilde desteklenmeyebilir. Ayrıca kötü niyetli botlar bu kuralları tamamen yok sayabilir.
## Robots.txt Dosyası Oluşturmak için Kullanılabilecek Araçlar Hangileridir?
Teknik SEO bilgisi gerektirmeden saniyeler içinde standartlara uygun dosyalar üreten birçok araç bulunur. Bu araçlar, kullanıcıdan aldığı basit komutları doğru sözdizimine çevirir.
#### SEO Platformlarının Ücretsiz Araçları
**SEOptimer, SE Ranking, DNSChecker** gibi araçlar, tarayıcı tabanlı ücretsiz robots.txt oluşturucu araçlar sunar. Bu araçların arayüzünde, hangi botlara izin verileceğini ve hangi dizinlerin engelleneceğini açılır menüler aracılığıyla seçersiniz. Araç, seçimlerinizi anında geçerli bir metin dosyasına dönüştürür. Özellikle statik web siteleri veya özel yazılımlı küçük projeler için bu araçlar pratik bir başlangıç noktasıdır.
#### İçerik Yönetim Sistemi (CMS) Eklentileri
WordPress gibi içerik yönetim sistemlerinde, dosyayı sunucuya FTP ile yüklemek yerine SEO eklentileri kullanılır. WordPress robots.txt ayarları genellikle **RankMath, Yoast SEO ve All in One SEO (AIOSEO)** gibi eklentiler üzerinden yönetilir. Bu eklentiler, sitenin XML site haritası URL’sini dosyaya otomatik olarak ekler ve sistemin çekirdek dosyalarını (örneğin wp-admin) varsayılan olarak taramaya kapatır.
#### E-Ticaret ve CMS Altyapılarında Robots.txt Yönetimi
**E-ticaret sitelerinde robots.txt yapılandırması**, standart blog veya kurumsal sitelerden tamamen farklı bir tarama mantığı gerektirir. Sepet sayfaları, ödeme adımları, kullanıcı panelleri ve sonsuz döngü yaratan dinamik filtreleme parametreleri arama motoru botlarına kesinlikle kapatılmalıdır. Aksi takdirde sitenizin tarama bütçesi (crawl budget) boşa harcanır ve asıl trafik getirecek ürün sayfalarının indekslenmesi gecikir.
Çoğu e-ticaret altyapısı temel bir dosya sunsa da, bu şablonlar genellikle manuel optimizasyon gerektirir. **ikas, e-ticaretin sitesinin URL yapısına ve arama motoru yönergelerine tam uyumlu bir robots.txt dosyasını varsayılan olarak hazır sunar**. Böylece robots.txt dosyası kuralı yazma veya diğer teknik ayarlarla vakit kaybetmeden, sitenizin diğer geliştirme süreçlerine odaklanabilirsiniz.
#### Özel Yazılımlar vs. Hazır Sistemler
Özel yazılım e-ticaret projelerinde geliştirici ekibin robots.txt kurallarını manuel olarak tanımlaması ve her yeni modülde güncellemesi gerekir. Bu durum, teknik SEO hatalarına açık bir zemin yaratır.
Buna karşın, **ikas gibi modern e-ticaret altyapıları bu süreci arka planda otomatik olarak yönetir**. Özellikle e-ticaret operasyonlarında ikas, e-ihracat ve çok kanallı satış süreçlerinde binlerce ürün URL’si oluşsa bile, arama motoru botlarının yalnızca dizinleme yapması gereken sayfalara odaklanmasını sağlayan **standart bir robots.txt dosyasını hazır sunar**. Böylece mağaza sahiplerinin kod yazmaya veya robots.txt düzenleme adımlarıyla uğraşmasına gerek kalmaz.
## Robots.txt Kuralları Nasıl Yazılır?
Arama motoru botlarının web sitenizde hangi sayfaları ve dizinleri tarayabileceğini belirlemek için kullanılan talimatlara **kural (directive)** denir. Doğru yapılandırılmış bir robots.txt dosyası, arama motorlarının gereksiz URL’leri taramasını engelleyerek tarama kaynaklarının daha verimli kullanılmasına yardımcı olabilmektedir. Ancak robots.txt, sayfaların arama sonuçlarında indekslenmesini doğrudan engellemez. İndekslemeyi önlemek için noindex gibi farklı yöntemler kullanılmalıdır.
Dosyanıza kural eklerken şu teknik esasları temel almalısınız:
- **Kural Grupları ve User-agent:** Robots.txt dosyası, botlara yönelik kural grupları halinde organize edilir. Her grup, kuralların hangi bota (örneğin Googlebot) uygulanacağını belirten bir User-agent satırıyla başlar.
- **Komutların İşlevi:** Bir kural grubu temelde şu üç soruyu yanıtlar:
- Bu kural hangi bot için geçerli? **(User-agent)**
- Bot hangi dizinlere veya dosyalara erişebilir? **(Allow)**
- Bot hangi dizinleri veya dosyaları taramamalı? **(Disallow)**
- **İşlem Sırası ve Birleştirme:** Tarayıcılar robots.txt dosyasını değerlendirirken kendileriyle eşleşen en spesifik **User-agent** grubunu dikkate alır. Google, aynı bota yönelik birden fazla eşleşen grup bulunması durumunda bu grupların kurallarını birleştirir. Allow ve Disallow kuralları çakıştığında ise en spesifik yol kuralı uygulanır. Eşit derecede spesifik kurallarda **Google, Allow kuralına öncelik verir**.
- **Varsayılan İzin (Default Allow):** Disallow komutuyla açıkça engellemediğiniz sürece botların sitenizdeki sayfaları ve dizinleri taramasına izin verildiği varsayılır. Bu nedenle tüm siteyi taramaya açmak için ayrıca Allow: / yazmanız zorunlu değildir.
- **Büyük/Küçük Harf Duyarlılığı:** Allow ve Disallow komutlarında belirtilen URL yolları büyük/küçük harfe duyarlıdır. **Örneğin Disallow: /dosya.asp kuralı, /dosya.asp yolunu engellerken /DOSYA.asp yolunu engellemez**. Ancak User-agent, Allow ve Disallow gibi komut adları büyük/küçük harfe duyarlı değildir.
- **Yorum Satırları:** Robots.txt dosyanızda notlar bırakmak isterseniz satır başına # işareti koyabilirsiniz. **\# karakteri bir yorumun başlangıcını belirtir ve tarayıcılar yorumları kural olarak işlemez**.
### Geçerli Robots.txt Kurallarına Örnekler
Farklı senaryolara göre hazırlanmış geçerli kural örneklerini aşağıdaki tabloda inceleyebilirsiniz:
| Kural Amacı | Kural Örneği | Kural Açıklaması |
| --- | --- | --- |
| Tüm botların siteyi taramasına izin vermek | User-agent: \*
Allow: / | Robots.txt kurallarına uyan tüm botların siteyi taramasına izin verir. |
| Tüm botların siteyi taramasını engellemek | User-agent: \*
Disallow: / | Kök dizini temsil eden / işareti, tüm URL yollarıyla eşleşir ve robots.txt kurallarına uyan botların siteyi taramasını engeller. |
| Googlebot’un belirli bir klasörü (/admin/) taramasını engellemek | User-agent: Googlebot
Disallow: /admin/ | Googlebot’un /admin/ klasöründeki URL’leri taramasını engeller. Ancak bu kural, klasöre kullanıcı erişimini engellemez. |
| Tüm siteyi GPTBot’un taramasına kapatmak | User-agent: GPTBot
Disallow: / | OpenAI’ın model eğitimi amacıyla içerik tarayan GPTBot’una erişim izni verilmediğini belirtir. Ancak dikkat! Bu kural, ChatGPT arama sonuçlarını yöneten OAI-SearchBot’u otomatik olarak engellemez. |
| Yorum satırı eklemek | \# Bu bir e-ticaret sitesine ait robots.txt dosyasıdır. | Robots.txt dosyasını okuyanlar için eklenen bir yorum satırıdır. Bu satırlar işleme sırasında yok sayılır. Bazı markalar bu yorum satırına logo eklemeleri yaparak dikkat çekici bir robots.txt dosyası oluşturabilmektedir. Örnek olarak [ikas’ın robots.txt dosyasına](https://ikas.com/robots.txt) ve [Nike’nin robots.txt dosyasına](https://www.nike.com/robots.txt) göz atabilirsiniz. |
## Robots.txt Dosyası Nasıl Test Edilir?
Robots.txt dosyanızdaki kuralların doğru çalışıp çalışmadığını kontrol etmek için kullanabileceğiniz **en önemli araçlardan biri Google Search Console’dur**.
Robots.txt dosyanıza yanlışlıkla eklenen **Disallow: / komutu**, Googlebot’un web sitenizdeki tüm sayfaları taramasını engelleyebilir. Ancak bu durum, sitenizin arama sonuçlarından otomatik olarak tamamen kaldırılacağı anlamına gelmez. Google, başka kaynaklardan keşfettiği URL’leri, içeriklerini tarayamasa bile arama sonuçlarında gösterebilir. Tabii isteyerek eklemediğiniz sürece robots.txt dosyanızda böyle bir komutun (Disallow: /) olmasını istemeyiz.
Bu tür sorunları tespit etmek için **Google Search Console (GSC)** üzerinden test yapabilirsiniz. GSC’deki **URL Denetimi** aracıyla belirli bir sayfanın robots.txt tarafından engellenip engellenmediğini kontrol edebilirsiniz.
Ayrıca **GSC > Ayarlar > Tarama > robots.txt** bölümündeki rapordan Google’ın dosyanıza erişim durumunu, son kontrol tarihini ve tespit edilen sözdizimi sorunlarını inceleyebilirsiniz. Raporda karşılaşabileceğiniz durumlar şunlardır:
- **Getirilmedi – Bulunamadı (404):** Google, robots.txt dosyanızı belirtilen adreste bulamamıştır. Dosyanın doğru konumda (https://siteadresiniz.com/robots.txt) bulunduğunu kontrol edin. Robots.txt dosyasının bulunmaması tek başına teknik bir hata değildir. Google, dosya bulunmadığında sitenizdeki URL’leri robots.txt kısıtlaması olmadan tarayabilir. Dosya **30 gün boyunca 404 durumunda kalırsa rapordan kaldırılır** ancak Google arka planda kontrol etmeye devam eder.
- **Getirilmedi – Başka bir neden:** Google, robots.txt dosyasına erişirken 404 dışında bir sorunla karşılaşmıştır. Bunun nedeni; **sunucu hataları (5xx), DNS sorunları, zaman aşımı veya bağlantı problemleri** olabilir. Bu durumda **sunucu günlüklerini, güvenlik duvarı (WAF) ayarlarını ve bağlantı sorunlarını** kontrol edin. Özellikle 5xx hataları Google’ın sitenizi taramasını geçici olarak durdurabilir veya sınırlandırabilir.
- **Getirildi:** Googlebot, robots.txt dosyanıza başarıyla erişmiştir. Ancak bu durum, **dosyadaki tüm kuralların doğru olduğu anlamına gelmez**. Sözdizimi hataları veya uyarılar varsa raporun **Sorunlar** bölümünde görüntülenir. Google, hatalı satırları yok sayarak yorumlayabildiği geçerli kuralları uygulamaya devam eder.
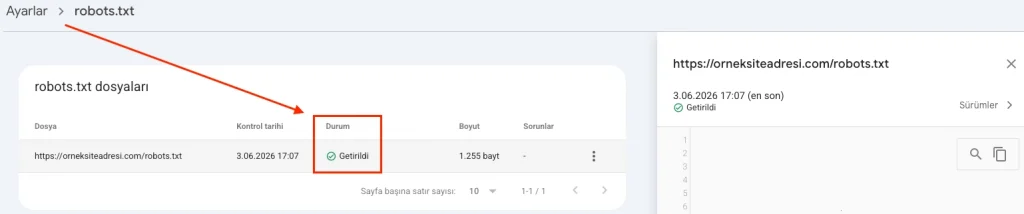
📌 **Ek bilgi:** Robots.txt dosyanızdaki hataları düzelttikten sonra Search Console üzerinden dosyanın yeniden taranmasını isteyebilirsiniz. Belirli URL’lerin taranmasına izin verilip verilmediğini ise **URL Denetimi** aracıyla kontrol edebilirsiniz. Sözdizimi ve kuralları daha ayrıntılı test etmek için bir robots.txt doğrulama aracı da kullanabilirsiniz.
## E-Ticaret Sitelerinde Robots.txt Kullanmak Neden Önemlidir?
E-ticaret siteleri, standart web sayfalarından farklı olarak dinamik bir mimariyle çalışır. Binlerce ürün, kategori ve filtreleme seçeneği bir araya geldiğinde sitenin URL sayısı kontrolsüz biçimde çoğalabilir. Organik trafiği ve dönüşümü artırmanın önemli adımlarından biri, SEO açısından değerli ürün ve kategori sayfalarının Google tarafından verimli şekilde taranmasını sağlamaktır.
Geniş kataloglu e-ticaret sitelerinde tarama bütçesi (crawl budget) yönetimi, arama motorlarının siteyi ne kadar verimli taradığını doğrudan etkiler. Tarama bütçesi sınırsız bir kaynak değildir; Google’ın sitenizi incelemek için ayırdığı zaman ve kapasite, sitenin büyüklüğüne, içeriklerin güncellenme sıklığına ve sunucu performansına bağlı olarak değişir. Renk, beden veya fiyat aralığı gibi filtre kombinasyonları, arama motorları için SEO değeri taşımayan çok sayıda parametreli URL oluşturabilir.
Robots.txt dosyasıyla bu URL’lerin taranmasını sınırlandırmazsanız, Googlebot gereksiz sayfalara zaman ayırabilir. Özellikle büyük e-ticaret sitelerinde bu durum, yeni eklenen veya güncellenen önemli ürün sayfalarının keşfedilmesini geciktirebilir. Ayrıca botların çok sayıda filtre sayfasına erişmesi, sunucu kaynaklarının gereksiz kullanılmasına ve yoğun dönemlerde site performansının olumsuz etkilenmesine neden olabilir.
**Peki bu israf nasıl önlenir?** SEO açısından değer taşımayan parametreli URL’lerin taranmasını robots.txt dosyası üzerinden sınırlandırmak etkili yöntemlerden biridir. ikas gibi yeni nesil e-ticaret platformları, gereksiz URL taramalarını azaltmaya yönelik altyapı çözümleri sunabilir. Ancak kullanılan platformdan bağımsız olarak robots.txt kurallarının sitenin URL yapısına uygun olması gerekir. Böylece arama motorlarının önemli sayfalara erişmesi kolaylaştırılabilir.
Robots.txt dosyasının taramayı kontrol ettiğini, ancak bir URL’nin Google dizinine eklenmesini kesin olarak engellemediğini de unutmamak gerekir.
## E-Ticaret Siteleri için İdeal Robots.txt Kurgusu Nasıl Olmalıdır?
E-ticaret sitelerinde robots.txt dosyasını kurgularken temel amaç, arama motoru botlarının gereksiz sayfalardan uzak tutulup SEO açısından değerli sayfalara yönlendirilmesidir. Yanlış bir kurgu, sitenizin arama motoru görünürlüğüne ciddi zararlar verebilir. Bu nedenle robots.txt dosyası, sitenin gerçek URL yapısı ve SEO stratejisi dikkate alınarak hazırlanmalıdır.
Aşağıda, bir [e-ticaret sitesi kur](https://ikas.com/tr/blog/e-ticaret-sitesi-kurma-rehberi)arken uygulanabilecek temel robots.txt yapılandırma adımlarını bulabilirsiniz.
### Sepet, Ödeme ve Üye Giriş Sayfalarını Engelleme
Kullanıcıların sepetlerini görüntülediği, sipariş işlemlerini tamamladığı veya hesaplarına giriş yaptığı sayfalar, genellikle organik trafik açısından değer taşımaz. Bu sayfaların gereksiz yere taranmasını sınırlandırmak, özellikle büyük e-ticaret sitelerinde tarama kaynaklarının daha verimli kullanılmasına yardımcı olabilir.
**Örnek robots.txt kuralları:**
User-agent: \*
Disallow: /sepet/
Disallow: /odeme/
Disallow: /hesabim/
Bu kurallar, belirtilen URL yollarının taranmasını engeller. Ancak robots.txt bir güvenlik aracı değildir. Kullanıcı hesaplarını ve kişisel verileri korumak için uygun kimlik doğrulama ve erişim kontrolü mekanizmaları kullanılmalıdır.
Ayrıca bu kuralların indekslemeyi kesin olarak engellemediğini unutmamak gerekir. Bir sayfanın Google arama sonuçlarında görünmesini önlemek için, sayfa taranabilir durumdayken noindex direktifi kullanılabilir.
### Filtreleme (Faceted Navigation) ve Parametre URL’leri Yönetimi
E-ticaret sitelerindeki en büyük tarama bütçesi israfı kaynaklarından biri filtreli navigasyondur (faceted navigation).
**“Kırmızı”, “M beden”, “En düşük fiyat”** gibi filtreler seçildiğinde URL’nin sonuna parametreler eklenebilir. Örneğin: **/urunler?renk=kirmizi&beden=m**
Bu filtreler farklı şekillerde birleştirildiğinde binlerce URL oluşabilir. SEO açısından değer taşımayan filtre kombinasyonlarının taranmasını engellemek, botların gereksiz URL’lere erişmesini azaltabilir.
**Örnek robots.txt kuralları:**
User-agent: \*
Disallow: /\*?renk=
Disallow: /?beden=
Disallow: /?siralama=
Disallow: /?\*fiyat=
Bu örneklerde \* karakteri, URL içerisinde farklı karakterlerin bulunabileceğini ifade eder. Böylece ilgili parametrelerin farklı kombinasyonlarda yer aldığı URL’lerin taranması sınırlandırılabilir.
**Önemli:** Her filtre sayfası SEO açısından değersiz değildir. Örneğin “Kadın Siyah Elbise” gibi arama talebi bulunan ve özgün içerik sunan filtreli kategori sayfaları organik trafik elde edebilir. Bu nedenle arama motorlarında görünmesini istediğiniz filtre sayfalarını engellememelisiniz.
Ayrıca örnekteki parametre adları, kullanılan e-ticaret altyapısına göre değişebilir. Kuralların gerçek URL yapınıza uygun olması ve istenmeyen başka parametrelerle eşleşmemesi gerekir.
### Site İçi Arama Sonuçlarını Taramaya Kapatma
Müşterilerinizin site içi arama çubuğunu kullanarak yaptığı sorgular, dinamik arama sonuç sayfaları oluşturabilir. Bu sayfalar çok sayıda benzer veya düşük değerli URL’nin oluşmasına neden olabilir.
Arama sonuçlarının gereksiz yere taranmasını sınırlandırmak için aşağıdaki gibi kurallar kullanılabilir:
User-agent: \*
Disallow: /arama?q=
Disallow: /search/
Bu örnekler, arama sonuçlarının belirtilen URL yapılarında oluşturulduğu siteler için geçerlidir.
**Not:** Bu URL yolları yalnızca örnektir. Her web sitesinde arama sonuçlarının URL yapısı farklılık gösterebilir. Kendi e-ticaret sitenizde uygulama yapmadan önce mevcut URL yapınızı incelemeli ve robots.txt dosyanızı test etmelisiniz.
### XML Site Haritası (Sitemap) Bildirimi Ekleme
Arama motoru botlarına sitenizde hangi dizinleri taramayacaklarını belirttikten sonra, odaklanmaları gereken sayfaları da net biçimde işaret etmelisiniz. **Robots.txt dosyasının en sonuna XML site haritanızın (sitemap) tam URL’sini eklemek**, yeni eklediğiniz ürün sayfalarının tarama kuyruğuna daha verimli bir şekilde dahil olmasına yardımcı olur.
Sitemap: https://www.siteniz.com/sitemap.xml
## E-Ticaret Sitesi için Robots.txt Dosyası Örneği
Aşağıda, standart bir e-ticaret sitesi için hazırlanmış, gereksiz URL taramalarını sınırlandırmaya yönelik örnek bir robots.txt dosyası yer almaktadır.
User-agent: \*
Disallow: /admin/
Disallow: /sepet/
Disallow: /odeme/
Disallow: /hesabim/
Disallow: /arama?q=
Disallow: /search/
Disallow: /\*?renk=
Disallow: /?beden=
Disallow: /?siralama=
Disallow: /?\*fiyat=
Sitemap: https://www.siteniz.com/sitemap.xml
Bu yapılandırma, belirtilen sepet, ödeme, hesap, arama ve filtreleme URL’lerinin taranmasını sınırlandırırken ürün ve kategori sayfalarına yönelik genel bir engelleme oluşturmaz.
Ürün görsellerinin Google tarafından taranabilmesi için görsel dosyalarının da erişilebilir olması gerekir. Bu nedenle, özel bir gereksinim bulunmadıkça ürün görsellerinin bulunduğu dizinler robots.txt üzerinden engellenmemelidir.
📌 **Not:** Bu dosya her e-ticaret sitesine doğrudan uygulanabilecek hazır bir çözüm değildir. URL yolları, filtre parametreleri ve sitemap adresi kullanılan altyapıya göre değişiklik gösterebilir. Özellikle organik trafik alan filtre sayfalarının yanlışlıkla engellenmediğinden emin olunmalıdır.
## Sık Yapılan Robots.txt Hataları ve Çözümleri
Robots.txt dosyası güçlü bir araçtır ancak yanlış yapılandırıldığında sitenizin organik görünürlüğünü olumsuz etkileyebilir. E-ticaret yöneticilerinin en sık karşılaştığı hataları ve bu hataların nasıl çözülebileceğini bilmek oldukça önemlidir.
### Tüm Siteyi Taramaya Kapatmak (Disallow: /)
En kritik ve sık karşılaşılan hatalardan biri, Disallow komutunun yanına sadece bir eğik çizgi (/) koymaktır.
User-agent: \*
Disallow: /
Bu tek bir karakter, ilgili kuralların geçerli olduğu arama motoru botlarına sitenin tamamının taranmaması gerektiğini bildirir. Genellikle sitenin yapım aşamasında eklenen bu komut, site yayına alındığında unutulabilir ve önemli sayfaların taranmasını engelleyebilir.
Bu durum mevcut indeks kayıtlarının tamamını anında silmese de yeni sayfaların keşfedilmesini ve mevcut içeriklerin güncellenmesini olumsuz etkileyebilir.
Çözümü, sitenin tamamını engelleyen kuralı kaldırmak ve yalnızca taranmasını istemediğiniz URL’leri sınırlandırmaktır.
### CSS ve JavaScript Dosyalarını Engellemek
Googlebot, sayfaları tıpkı gerçek bir kullanıcı gibi görsel olarak oluşturur (rendering). CSS ve JavaScript dosyalarına erişebilmesi, Google’ın sayfa düzenini, içerikleri ve kullanıcı deneyimini doğru şekilde anlaması açısından önemlidir.
Bu dosyaların robots.txt üzerinden engellenmesi, özellikle JavaScript ile oluşturulan içeriklerin Google tarafından işlenmesini zorlaştırabilir.
Bu nedenle sayfanın görüntülenmesi ve içeriğinin oluşturulması için gerekli CSS ve JavaScript dosyalarının taranmasına izin verilmelidir.
### Robots.txt ile İndekslemeyi Engellemeye Çalışmak
Sık yapılan hatalardan biri de robots.txt dosyasının bir sayfayı Google arama sonuçlarından tamamen kaldıracağını düşünmektir. Robots.txt taramayı engeller ancak Google, başka sayfalardan bağlantı verilen bir URL’yi içeriğini taramadan da indeksleyebilir. Bir sayfanın arama sonuçlarında görünmesini engellemek istiyorsanız, sayfanın taranmasına izin vererek noindex direktifini kullanabilirsiniz. Ancak **aynı sayfayı robots.txt üzerinden engellerseniz Googlebot sayfaya erişemeyeceği için noindex direktifini de göremez**.
### Google Search Console Üzerinden Hata Tespiti
Robots.txt dosyanızdaki hataları tespit etmenin en güvenilir yollarından biri **Google Search Console kullanmaktır**.
**Sayfa İndeksleme (Page Indexing) raporunda** yer alan **“robots.txt tarafından engellendi”** durumunu inceleyerek taranması engellenen URL’leri kontrol edebilirsiniz. Eğer burada önemli ürün veya kategori sayfalarınızı görüyorsanız, robots.txt kurallarınızı yeniden değerlendirmeniz gerekir.
**URL Denetimi (URL Inspection) aracı** üzerinden belirli bir sayfanın Google tarafından taranmasına izin verilip verilmediğini kontrol edebilirsiniz.
Ayrıca **Tarama İstatistikleri (Crawl Stats) raporu**, Googlebot’un sitenize yaptığı tarama istekleri hakkında bilgi verir. Robots.txt raporu üzerinden de dosyanızın Google tarafından erişilebilir olup olmadığını ve dosyayla ilgili sorunları inceleyebilirsiniz.
Robots.txt dosyanızda değişiklik yaptıktan sonra özellikle önemli ürün ve kategori sayfalarınızı yeniden kontrol etmeniz gerekir. Böylece gereksiz URL taramalarını sınırlandırırken organik trafik potansiyeli taşıyan sayfalarınızın erişilebilir kaldığından emin olabilirsiniz.
## Robots.txt Dosyası ile İlgili Sıkça Sorulan Sorular
### Robots.txt Dosyası Nerede Bulunur?
Web sitenizin kök dizininde bulunur. Tarayıcınızın adres çubuğuna **domainadresiniz.com/robots.txt** yazarak doğrudan erişebilirsiniz.
### Robots.txt Dosyasının Doğru Olup Olmadığını Nasıl Test Edebilirim?
Google Search Console aracındaki **“Ayarlar”** sayfasının içinde yer alan robots.txt raporunu inceleyerek dosyanızdaki komutların doğru çalışıp çalışmadığını öğrenebilirsiniz. Ek olarak, Google’da **“robots.txt checker”** araması yapabilir ve karşınıza çıkan web sitelerinde ilgili komutlarınızı test edebilirsiniz.
### Web Sitenizde Robots.txt Dosyası Olmazsa Ne Olur?
Web sitenizde bir robots.txt dosyası yoksa, Googlebot gibi arama motoru tarayıcıları karşılarına çıkan tüm URL’leri kısıtsızca tarar. Bu durum az sayfalı standart bir blog için sorun yaratmaz; ancak binlerce dinamik URL üreten platformlarda tarama bütçesi (crawl budget) hızla tükenir. Botlar; **“fiyata göre sırala” veya “beden filtrele”** gibi arama sonuçlarında organik değeri olmayan parametreli sayfalar arasında kaybolur. Sonuç olarak, asıl gelir getiren yeni ürün sayfalarınızın keşfedilmesi gecikir ve gereksiz bot trafiği sunucu kaynaklarını boşa harcar. Bu nedenle, [başarılı bir e-ticaret SEO stratejisi yürütmek](https://ikas.com/tr/blog/e-ticaret-seo) isteyen her marka, arama motoru botlarına doğru sınırları çizen optimize edilmiş bir robots.txt dosyası kullanmak zorundadır. Teknik detaylarla vakit kaybetmek istemeyen satıcılar için ikas gibi yeni nesil e-ticaret altyapıları, bu tür kritik dosyaları baştan en verimli şekilde yapılandırarak botların yalnızca satışa dönüşecek değerli sayfaları taramasını güvence altına alır.
### E-Ticaret Sitelerinde Robots.txt Dosyası Kullanmak Zorunlu mu?
Teknik olarak herhangi bir zorunluluk olmasa da, e-ticaret sitelerinde kesinlikle robots.txt dosyasını kullanılmalıdır. E-ticaret platformlarında **renk, beden, fiyat aralığı gibi filtreler (kapsamlı navigasyon)** binlerce farklı URL kombinasyonu ortaya çıkarır. Bu durum, [arama motorları](https://ikas.com/tr/blog/en-iyi-arama-motorlari)nın tarama bütçesini hızla tüketir. Tarama bütçesini daha etkili yönetebilmek adına robots.txt dosyası kullanımı kesinlikle faydalı olacaktır.
### Oluşturulan Robots.txt Dosyasını Google’a Nasıl Bildirebilirsiniz?
Robots.txt dosyasını oluşturduktan sonra kök dizine yüklemeniz yeterlidir. Botlar sitenizi ziyaret ettiklerinde bu dosyayı **otomatik olarak bulur ve okur**.
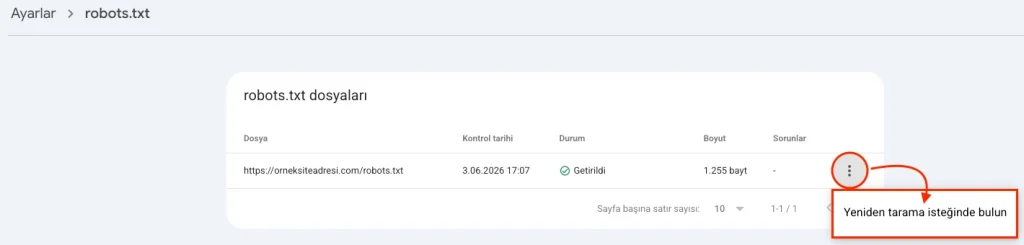
Ancak, dosyada yaptığınız kritik bir değişikliğin Google tarafından hızlıca fark edilmesini istiyorsanız, **Google Search Console** üzerinden ping atarak botları sitenize çağırabilirsiniz.
Bu işlemi gerçekleştirmek için **Google Search Console’daki Ayarlar > Tarama > Robots.txt raporuna gidin**. İlgili dosyanın yanındaki **“Diğer ayarlar (üç nokta)”** simgesine tıklayın ve **“Yeniden tarama isteğinde bulun”** seçeneğini seçin.
### Robots.txt Dosyasında “User-agent” Ne Anlama Gelir?
User-agent, bir web sitesini ziyaret eden tarayıcı veya arama motoru botu gibi yazılımların dijital kimlik kartıdır. Robots.txt dosyası içindeki User-agent yönergesi, yazılan tarama kurallarının tam olarak hangi bota uygulanacağını belirler.
**User-agent satırında asterisk (\*) işaretinin kullanılması**, ilgili kural setinin internetteki tüm tarayıcı botları için geçerli olduğu anlamına gelir. Spesifik bir botu hedeflemek gerektiğinde ise botun tam adı yazılır. Yalnızca Google’ın görsel tarayıcısına özel bir kural atamak için **User-agent: Googlebot-Image** yönergesi kullanılır. **Googlebot-Image yönergesi**, standart web sayfalarını tarayan genel **User-agent: Googlebot** komutuyla aynı şey değildir; her bot yalnızca kendi ismine tanımlanan kuralları dikkate alır.
### Robots.txt Dosyasında “Disallow” Komutları Nasıl Çalışır?
Disallow komutu, belirtilen User-agent’ın hangi dizinlere veya dosyalara erişemeyeceğini tanımlar. Bu komut URL yollarını eşleştirerek çalışır. Örneğin **Disallow: /admin/** yazdığınızda, URL’si **“/admin/”** ile başlayan hiçbir sayfa taranmaz. Ancak bu komutun sayfayı dizinden (indeksten) silmediğini unutmamalısınız; sayfa başka bir siteden link almışsa arama sonuçlarında URL olarak görünmeye devam eder.
### Sitemap Protokolü Neden Robots.txt Dosyasına Dahil Edilir?
Sitemap (Site Haritası) protokolü, arama motorlarına sitenizdeki tüm taranabilir sayfaların tam listesini sunar. Bu haritanın URL’sini robots.txt dosyasının en altına **Sitemap: https://orneksiteadi.com/sitemap.xml** formatında eklemek, botların siteye girdikleri anda haritayı bulmalarını sağlar. Özellikle yeni kurulan veya çok sık güncellenen sitelerde, içeriklerin çok daha hızlı keşfedilmesini gerçekleştirir.
### Robots.txt Dosyası SEO Optimizasyonunu Nasıl Etkiler?
Robots.txt dosyasının SEO performansına en somut katkısı, arama motoru botlarının siteye ayırdığı kısıtlı tarama bütçesini (crawl budget) doğrudan kârlı sayfalara yönlendirmesidir. Eski URL’leri, yönlendirme zincirlerini ve filtre parametrelerinden doğan kopya içerikleri disallow komutuyla engellediğinizde, Googlebot sunucu kaynaklarını değersiz sayfalarda boşa harcamaz. Bunun yerine yüksek kaliteli ürün sayfalarına ve ana kategorilere odaklanır. Özellikle binlerce ürün barındıran e-ticaret sitelerinde doğru yapılandırılmış bir robots.txt dosyası; yeni eklenen stokların, kampanyaların ve güncellenen fiyatların arama sonuçlarında indekslenme hızını doğrudan artırır.
📌 Ayrıntılı bilgileri en doğru kaynaktan öğrenmek için [Google’ın “Tarama bütçenizi optimize etme” rehberine](https://developers.google.com/crawling/docs/crawl-budget?hl=tr) göz atmanızı tavsiye ederiz.
### Herhangi Bir Sayfanın Dizinden Kaldırılması için Robots.txt Dosyası Kullanılabilir mi?
Web sayfalarınızı veya PDF gibi metin tabanlı dosyalarınızı Google arama sonuçlarından gizlemek için robots.txt dosyasına güvenmemeniz gerekir. Farklı bir web sitesi, gizlemek istediğiniz bu sayfalara bağlantı verdiğinde, Google botları sayfa içeriğini taramasa bile URL’yi doğrudan dizine ekleyebilir. Bu nedenle, **indekslemenin kesin olarak önüne geçebilmek için robots.txt yerine,** [sunucu düzeyinde şifre koruması veya sayfanın bölümünde noindex etiketi kullanın](https://developers.google.com/search/docs/crawling-indexing/robots/intro?hl=tr#:~:text=txt%20dosyas%C4%B1%20kullanabilirsiniz.-,Uyar%C4%B1%3A,-Web%20sayfalar%C4%B1n%C4%B1z%C4%B1%20%28PDF%27ler).
### Robots.txt Dosyası ve Noindex Arasındaki Farklar Nelerdir?
Robots.txt dosyası botların sayfayı taramasını (ziyaret etmesini) engeller, ancak sayfa başka sitelerden link almışsa veya daha önce botlar tarafından keşfedilmiş ise arama sonuçlarında görünebilir. Noindex etiketi ise botlara “bu sayfayı tarayabilirsin ama arama sonuçlarına kesinlikle ekleme” emrini verir.
📌 **Önemli İpucu:** Bir sayfanın arama sonuçlarından tamamen kaldırılması için noindex etiketi kullanıyorsanız, o sayfayı robots.txt dosyası üzerinden botlara engellemeyin. Arama motoru botları, robots.txt ile erişime kapatılmış bir URL’yi tarayamaz. Sayfa taranamadığı için HTML kaynak kodu okunmaz ve eklediğiniz noindex komutu botlar tarafından asla görülmez. Bu çelişkili senaryoda, sayfaya dışarıdan bir backlink geliyorsa veya URL daha önce keşfedilmişse, Google bu sayfayı dizine eklemeye devam eder. Hatta Search Console üzerinde **“robots.txt tarafından engelleniyor olsa da dizine eklendi”** uyarısıyla karşılaşırsınız. Kesin çözüm basittir: İndekslenmesini istemediğiniz sayfaları robots.txt dosyasında serbest bırakın ve yalnızca noindex etiketi kullanın. Botların sayfayı tarayıp “indekslenmeyecek” emrini bizzat okumasına izin verin.
### Robots.txt Dosya Boyutu ile İlgili Bir Sınırlandırma Var mı?
Google, robots.txt dosyaları için maksimum [500 kibibayt (KiB) boyut sınırı uygular](https://developers.google.com/crawling/docs/robots-txt/robots-txt-spec?hl=tr#:~:text=Google%20robots.txt%20dosyalar%C4%B1%20i%C3%A7in%20500%20kibibaytl%C4%B1k%20%28KiB%29%20bir%20boyut%20s%C4%B1n%C4%B1rlamas%C4%B1%20uygulamaktad%C4%B1r.). Yaklaşık 512 KB’a denk gelen bu eşik aşıldığında, Googlebot dosyanın 500 KiB’tan sonraki kısmını okumaz ve o bölümde yer alan tarama kurallarını tamamen yok sayar. Özellikle on binlerce ürün ve kategori sayfası barındıran e-ticaret sitelerinde, URL’leri tek tek engellemek yerine klasör bazlı (dizin) kurallar oluşturarak dosya boyutunu güvenli sınırın altında tutmak gerekir.
### Kategori Sayfaları Robots.txt ile Engellenmeli mi?
Hayır, ana kategori sayfaları e-ticaret sitelerinin en çok organik trafik çeken sayfalarıdır ve kesinlikle engellenmemelidir. Sadece bu kategoriler içindeki parametreli filtreleme URL’leri engellenmelidir.
### Robots.txt Değişiklikleri Ne Kadar Sürede Etki Eder?
Değişiklikler genellikle botların sitenizi bir sonraki ziyaretinde (çoğu zaman birkaç saat ile birkaç gün içinde) algılanır ve işleme alınır.
Yazan [Deha Yıldız](https://ikas.com/tr/author/deha) — SEO Uzmanı